机器学习中过拟合的定义及原因
2019年3月8日
成千上万的数据科学新手会在不知不觉中犯下一个错误,这个错误可以一手毁掉你的机器学习模型,这并不夸张。你知道是什么吗?
望里科技在利用人工智能进行研究的过程中,发现很多机器学习的研究者都会遇到过拟合的问题,因此也进行了一定的研究和思考。在本文中,我们将讨论应用机器学习中最棘手的障碍之一:过拟合(overfitting)。
‘’给定一个假设空间H,一个假设h属于H,如果存在其他的假设h’属于H,使得在训练样例上h的错误率比h’小,但在整个实例分布上h’比h的错误率小,那么就说假设h过度拟合训练数据。
-《Machine Learning》Tom M.Mitchell
一个机器学习算法满足什么条件才能被称得上是一个好算法?
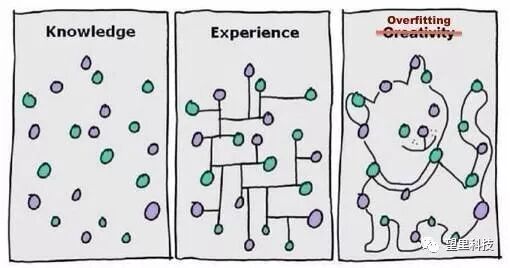
机器学习的主要挑战是我们的算法必须能够在先前未观测到的新输入上表现良好,而不只是在训练集上表现良好。这个很容易理解,因为我们平时里所做的就是给一个机器学习算法喂一大堆数据(训练集),然后希望这个算法在新数据(测试集)上有良好的性能。而这种在先前未观测到的输入上表现良好的能力被称为泛化能力。当你的模型学习到了训练数据的特质,但却不是你真正关心的东西的时候,这叫做“过拟合”。构建机器学习系统的人大部分时间都在担心这个问题。
没有机器学习经验的研究人员,对小样本数据进行特征提取和特征选择操作后,经常会得到一个正确率极高(90%以上)的模型,但是实际应用过程中发现该模型无法正常工作,正确率极低(低于60%)。
数据一般需要先转换成数据特征才能进行机器学习,样本数据的特征可以分为局部特征和全局特征,全局特征就是任何你想学习的那个概念所对应的数据都具备的特征,而局部特征则是你用来训练机器学习模型的样本里的数据专有的特征。打个形象的比方,让机器来学习天鹅的特征,经过训练后,知道了天鹅是有翅膀的,天鹅的嘴巴是长长的弯曲的,天鹅的脖子是长长的有点曲度,天鹅的整个体型像一个“2”且略大于鸭子。这时候你的机器已经基本能区别天鹅和其他动物了。
机器在学习过程中是无法区别局部特征和全局特征的,机器学习模型在完成训练后,除了学习到了数据的全局特征,也可能习得一部分局部特征,而习得的局部特征比重越多,那么新样本中不具有这些局部特征但具有全局特征的样本也越多,于是机器无法正确识别符合定义的“正确”样本的几率也会上升,也就是所谓的“泛化性”变差,这是过拟合会造成的最大问题。
所谓过拟合(overfitting),就是指把学习进行的太彻底,把样本数据的所有特征几乎都习得了,于是机器学到了过多的局部特征,过多的由于噪声带来的假特征,造成模型的“泛化性”和识别正确率几乎跌到谷点。以天鹅为例,如果这群天鹅全部是白色,机器经过学习之后会认为所有天鹅的羽毛都是白色的,那么在遇见黑色的天鹅时机器将不会将它判定为天鹅,白色就是这部分样本带来的局部特征。
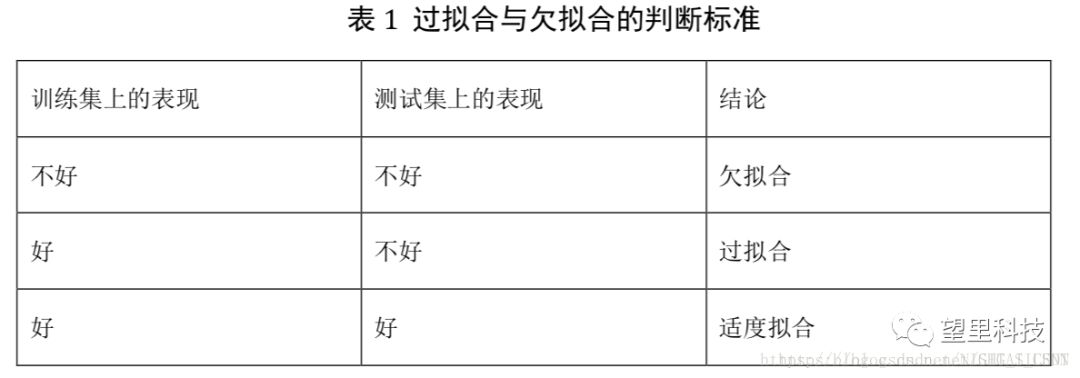
也就是说用这样的模型去预测原数据准确率非常高,但放在一组具有相同趋势但细节不同的数据里时,预测准确率就会变得极低。模型过度的拟合了训练数据,而没有考虑到泛化能力。
那么过拟合产生的原因是什么呢?
1 建模样本抽取偏差
机器学习过程大多是基于历史数据,建立模型,对未知数据进行预测。任何预测模型都是在假设的基础上才可以搭建和应用的,其中有个前提是假设数据满足独立同分布,即假设建模数据与后来的应用数据是相似的。但是一般独立同分布的假设往往不成立,即数据的分布可能会发生变化(distribution drift)。如果建模时的“逻辑假设”在模型应用时不能成立或与实际情况不符,那根据这些假设搭建的模型当然是无法有效应用的。
2 训练数据不足
如果训练数据有限,将无法体现数据整体的分布。在给定的不充分的数据集上学习到的模型,去预测未知数据集上的数据,很大可能产生过拟合现象。训练样本不足,又有样本抽取偏差时,基于此样本训练得到的模型泛化性能会更低。如果此时再对这些有偏差小样本进行特征选择操作,将很可能筛选出当前样本的局部特征、漏掉真正有效的全局特征,进而得到一个正确率极高、泛化极差的模型。
3 数据有噪声
当噪声数量在训练集中占有相当大的比例时,就会与正常数据一起影响训练集的分布,机器学习算法在学习过程中,把正常数据和噪声数据同时拟合,学习到了一个正常数据与噪声数据共同决定的模型,用此模型去预测从正常数据分布上取的未知数据,就很有可能得到不理想的泛化效果。
4 参数太多、模型复杂度高
在有噪声的训练数据中,如果训练过度,会让模型学习到噪声的特征,无疑是会造成在真实测试集上准确率下降。
过拟合是个在机器学习中非常常见的问题,这是因为机器学习算法为了满足尽可能复杂的任务,其模型的拟合能力一般远远高于问题复杂度,也就是说,机器学习算法有“拟合出正确规则的前提下,进一步拟合噪声”的能力。由于我们拟合的模型一般是用来预测未知数据(不在训练数据集内),过拟合虽然在训练集上效果很好,但是在实际使用时(测试集)效果很差,同时,在很多问题上,我们无法穷尽所有状态,不可能将所有情况都包含在训练集上,所以过拟合问题是值得每个机器学习研究者格外关注的问题。